
标签:
煎蛋网在反爬虫方面做了不少工作,无法通过正常的方式爬取,比如用下面这段代码爬取无法得到我们想要的源代码。
import requests

url = ‘http://jandan.net/ooxx‘
print requests.get(url).text
执行上述代码,你得到的结果应该跟我一样:
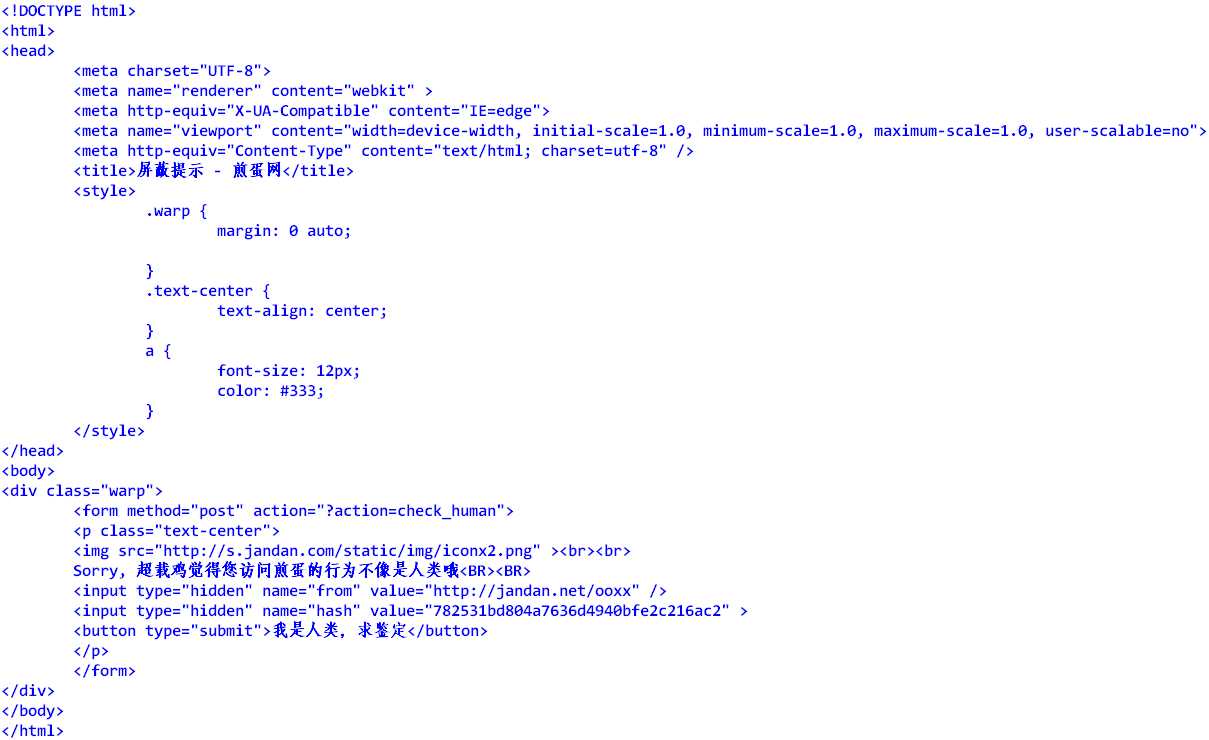
煎蛋网应该是通过检测headers来判断是否爬虫,要想获取正常的源代码,需要伪装成浏览器。
# -*- coding: utf-8 -*-
import re
import requests
from bs4 import BeautifulSoup

import sys
reload(sys)
sys.setdefaultencoding(‘utf8‘)

def get_bs(url):
    headers = {‘User-Agent‘: ‘Mozilla/5.0 (Windows NT 5.1) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/48.0.2564.82 Safari/537.36‘}
    text = requests.post(url, headers=headers).text
    return BeautifulSoup(text)

def download(url):
    fn = re.search(r‘.*/(.*)‘, url).group(1)
    content = requests.get(url).content
    with open(fn, ‘wb‘) as f:
        f.write(content)

if __name__ == ‘__main__‘:
    url = ‘http://jandan.net/ooxx‘
    bs = get_bs(url)
    for code in bs(‘li‘, id=re.compile(r‘comment-\d+‘)):
        url = code.find(‘img‘)[‘src‘]
        download(url)
当然,这个爬虫脚本也不是永久有效,说不定哪天煎蛋就出新招了,所以只能见招拆招。
爬虫实例——爬取煎蛋网OOXX频道(反反爬虫——伪装成浏览器)
标签:
原文地址:http://www.cnblogs.com/yestreenstars/p/5501028.html
