
标签:pre enc new logs col es2017 分享 png bs4
import requests   #HTTP库 从html或xml中提取数据
from bs4 import BeautifulSoup #爬虫库BeautifulSoup4
url = requests.get("http://news.gzcc.cn/html/xiaoyuanxinwen/")
url.encoding = "utf-8"
soup = BeautifulSoup(url.text,‘html.parser‘)
#print(soup.head.title.text)

#找出含有特定标签的html元素:‘ID’前缀‘#’;‘class’前缀‘.’,其它直接soup.select(‘p‘)
for news in soup.select(‘li‘):
    if len(news.select(‘.news-list-title‘))>0:


        time = news.select(‘.news-list-info‘)[0].contents[0].text #时间
        title = news.select(‘.news-list-title‘)[0].text           #标题
        href = news.select(‘a‘)[0][‘href‘]                        #链接

        href_text = requests.get(href)                            #链接内容
        href_text.encoding = "utf-8"
        href_soup = BeautifulSoup(href_text.text,‘html.parser‘)
        href_text_body = href_soup.select(‘.show-content‘)[0].text
        print(time,title,href,href_text_body)
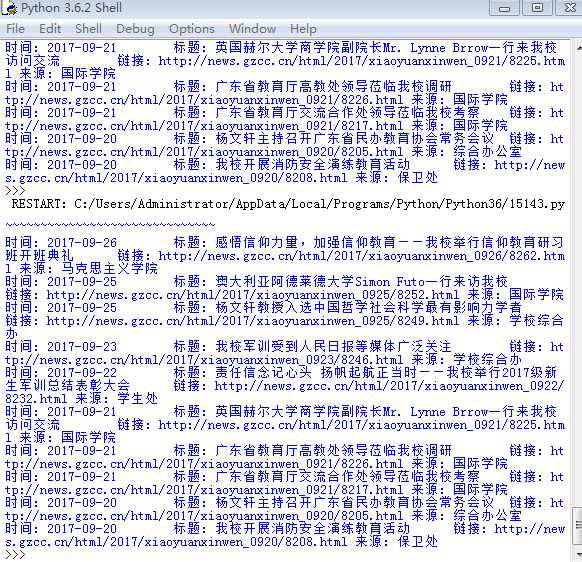
用requests库和BeautifulSoup4库爬取新闻列表
标签:pre enc new logs col es2017 分享 png bs4
原文地址:http://www.cnblogs.com/xialuokesh/p/7607153.html
