标签:bre panda ima end cli 结构化 getc one code
一、结构化
1、单条新闻的详情字典:news
import requests
from bs4 import BeautifulSoup
from datetime import datetime
import re
import pandas
import sqlite3
def getclick(url):
    m = re.search(r‘_(.*).html‘,url)
    newsid = m.group(1)[5:]
    clickurl = ‘http://oa.gzcc.cn/api.php?op=count&id={}&modelid=80‘.format(newsid)
    resc = requests.get(clickurl).text
    r = re.search(r"hits(.*)",resc).group(1)
    click = r.lstrip("‘).html(‘").rstrip("‘);")
    return(int(click))

def getdetail(url):
    resd = requests.get(url)
    resd.encoding=‘ute-8‘
    soupd = BeautifulSoup(resd.text,‘html.parser‘)
    news = {}
    news[‘url‘] = url
    news[‘title‘] = soupd.select(‘.show-title‘)[0].text
    info = soupd.select(‘.show-info‘)[0].text
    #news[‘dt‘] = datetime.strptime(info.lstrip(‘发布时间:‘)[0:19],‘%Y-%m-%d %H:%M‘)
    #news[‘source‘] = re.search(‘来源:(.*)点击‘,info).group(1).strip()
    news[‘content‘] = soupd.select(‘.show-content‘)[0].text.strip()
    news[‘click‘]=getclick(url)
    return(news)

def onepage(pageurl):
    res = requests.get(pageurl)
    res.encoding = ‘utf-8‘
    soup = BeautifulSoup(res.text,‘html.parser‘)
    newsls = []
    for news in soup.select(‘li‘):
        if len(news.select(‘.news-list-title‘))>0:
            newsls.append(getdetail(news.select(‘a‘)[0][‘href‘]))
            break
    return(newsls)
print(onepage(‘http://news.gzcc.cn/html/xiaoyuanxinwen/‘))
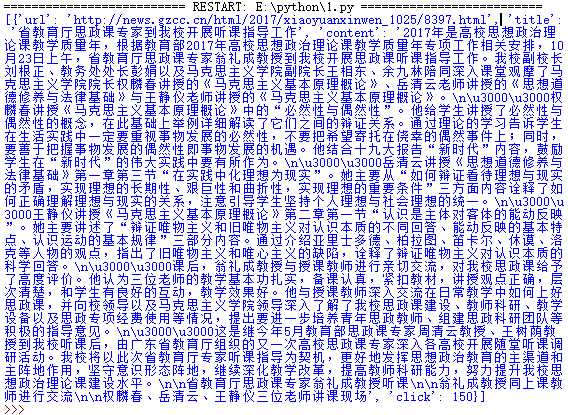
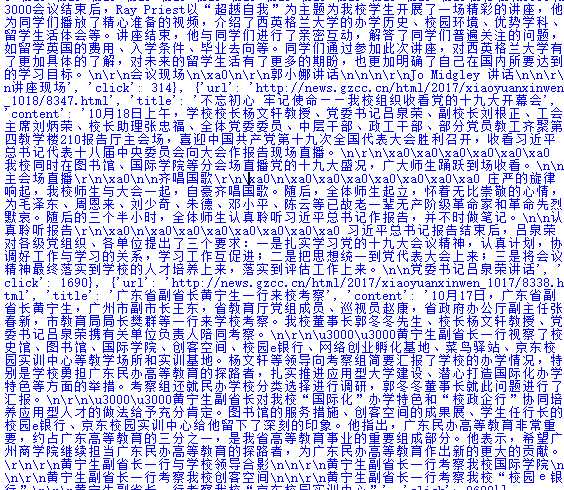
2、一个列表页所有单条新闻汇总列表:newsls.append(news)
import requests
from bs4 import BeautifulSoup
from datetime import datetime
import re
import pandas
import sqlite3
def getclick(url):
    m = re.search(r‘_(.*).html‘,url)
    newsid = m.group(1)[5:]
    clickurl = ‘http://oa.gzcc.cn/api.php?op=count&id={}&modelid=80‘.format(newsid)
    resc = requests.get(clickurl).text
    r = re.search(r"hits(.*)",resc).group(1)
    click = r.lstrip("‘).html(‘").rstrip("‘);")
    return(int(click))

def getdetail(url):
    resd = requests.get(url)
    resd.encoding=‘ute-8‘
    soupd = BeautifulSoup(resd.text,‘html.parser‘)
    news = {}
    news[‘url‘] = url
    news[‘title‘] = soupd.select(‘.show-title‘)[0].text
    info = soupd.select(‘.show-info‘)[0].text
    #news[‘dt‘] = datetime.strptime(info.lstrip(‘发布时间:‘)[0:19],‘%Y-%m-%d %H:%M‘)
    #news[‘source‘] = re.search(‘来源:(.*)点击‘,info).group(1).strip()
    news[‘content‘] = soupd.select(‘.show-content‘)[0].text.strip()
    news[‘click‘]=getclick(url)
    return(news)

def onepage(pageurl):
    res = requests.get(pageurl)
    res.encoding = ‘utf-8‘
    soup = BeautifulSoup(res.text,‘html.parser‘)
    newsls = []
    for news in soup.select(‘li‘):
        if len(news.select(‘.news-list-title‘))>0:
            newsls.append(getdetail(news.select(‘a‘)[0][‘href‘]))
    return(newsls)
print(onepage(‘http://news.gzcc.cn/html/xiaoyuanxinwen/‘))
3、所有列表页的所有新闻汇总列表:newstotal.extend(newsls)
import requests
from bs4 import BeautifulSoup
from datetime import datetime
import re
import pandas
import sqlite3
def getclick(url):
    m = re.search(r‘_(.*).html‘,url)
    newsid = m.group(1)[5:]
    clickurl = ‘http://oa.gzcc.cn/api.php?op=count&id={}&modelid=80‘.format(newsid)
    resc = requests.get(clickurl).text
    r = re.search(r"hits(.*)",resc).group(1)
    click = r.lstrip("‘).html(‘").rstrip("‘);")
    return(int(click))

def getdetail(url):
    resd = requests.get(url)
    resd.encoding=‘ute-8‘
    soupd = BeautifulSoup(resd.text,‘html.parser‘)
    news = {}
    news[‘路径‘] = url
    news[‘标题‘] = soupd.select(‘.show-title‘)[0].text
    info = soupd.select(‘.show-info‘)[0].text
    #news[‘dt‘] = datetime.strptime(info.lstrip(‘发布时间:‘)[0:19],‘%Y-%m-%d %H:%M‘)
    #news[‘source‘] = re.search(‘来源:(.*)点击‘,info).group(1).strip()
    #news[‘content‘] = soupd.select(‘.show-content‘)[0].text.strip()
    news[‘点击数‘]=getclick(url)
    return(news)

def onepage(pageurl):
    res = requests.get(pageurl)
    res.encoding = ‘utf-8‘
    soup = BeautifulSoup(res.text,‘html.parser‘)
    newsls = []
    for news in soup.select(‘li‘):
        if len(news.select(‘.news-list-title‘))>0:
            newsls.append(getdetail(news.select(‘a‘)[0][‘href‘]))
    return(newsls)
newstotal = []
gzccurl = ‘http://news.gzcc.cn/html/xiaoyuanxinwen/‘
newstotal.extend(onepage(gzccurl))

res = requests.get(gzccurl)
res.encoding=‘utf-8‘
soup = BeautifulSoup(res.text,‘html.parser‘)
n = int(soup.select(‘.a1‘)[0].text.rstrip(‘条‘))
pages=n//10+1
for i in range(2,3):
    listurl=‘http://news.gzcc.cn/html/xiaoyuanxinwen/{}.html‘.format(i)
    newstotal.extend(onepage(listurl))
print(newstotal)
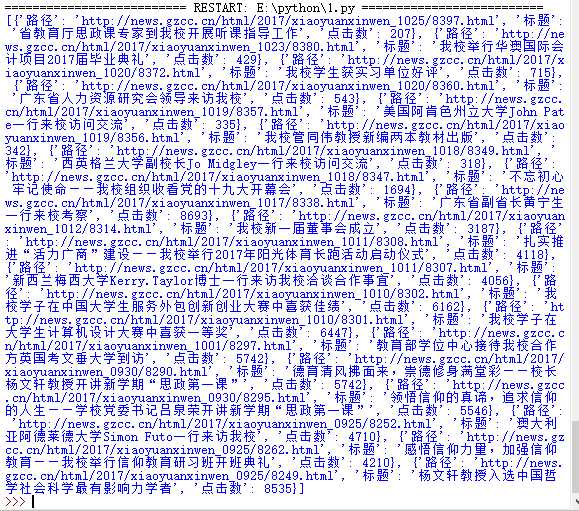
二、转换成pandas的数据结构DataFrame
import requests
from bs4 import BeautifulSoup
from datetime import datetime
import re
import pandas
import sqlite3
def getclick(url):
    m = re.search(r‘_(.*).html‘,url)
    newsid = m.group(1)[5:]
    clickurl = ‘http://oa.gzcc.cn/api.php?op=count&id={}&modelid=80‘.format(newsid)
    resc = requests.get(clickurl).text
    r = re.search(r"hits(.*)",resc).group(1)
    click = r.lstrip("‘).html(‘").rstrip("‘);")
    return(int(click))

def getdetail(url):
    resd = requests.get(url)
    resd.encoding=‘ute-8‘
    soupd = BeautifulSoup(resd.text,‘html.parser‘)
    news = {}
    news[‘路径‘] = url
    news[‘标题‘] = soupd.select(‘.show-title‘)[0].text
    info = soupd.select(‘.show-info‘)[0].text
    #news[‘dt‘] = datetime.strptime(info.lstrip(‘发布时间:‘)[0:19],‘%Y-%m-%d %H:%M‘)
    #news[‘source‘] = re.search(‘来源:(.*)点击‘,info).group(1).strip()
    #news[‘content‘] = soupd.select(‘.show-content‘)[0].text.strip()
    news[‘点击数‘]=getclick(url)
    return(news)

def onepage(pageurl):
    res = requests.get(pageurl)
    res.encoding = ‘utf-8‘
    soup = BeautifulSoup(res.text,‘html.parser‘)
    newsls = []
    for news in soup.select(‘li‘):
        if len(news.select(‘.news-list-title‘))>0:
            newsls.append(getdetail(news.select(‘a‘)[0][‘href‘]))
    return(newsls)
newstotal = []
gzccurl = ‘http://news.gzcc.cn/html/xiaoyuanxinwen/‘
newstotal.extend(onepage(gzccurl))

res = requests.get(gzccurl)
res.encoding=‘utf-8‘
soup = BeautifulSoup(res.text,‘html.parser‘)
n = int(soup.select(‘.a1‘)[0].text.rstrip(‘条‘))
pages=n//10+1
for i in range(2,3):
    listurl=‘http://news.gzcc.cn/html/xiaoyuanxinwen/{}.html‘.format(i)
    newstotal.extend(onepage(listurl))

df = pandas.DataFrame(newstotal)
print(df.head())
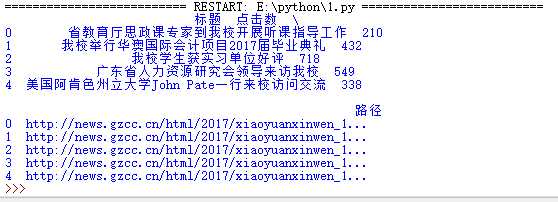
三、从DataFrame保存到excel
import requests
from bs4 import BeautifulSoup
from datetime import datetime
import re
import pandas
import sqlite3
def getclick(url):
    m = re.search(r‘_(.*).html‘,url)
    newsid = m.group(1)[5:]
    clickurl = ‘http://oa.gzcc.cn/api.php?op=count&id={}&modelid=80‘.format(newsid)
    resc = requests.get(clickurl).text
    r = re.search(r"hits(.*)",resc).group(1)
    click = r.lstrip("‘).html(‘").rstrip("‘);")
    return(int(click))

def getdetail(url):
    resd = requests.get(url)
    resd.encoding=‘ute-8‘
    soupd = BeautifulSoup(resd.text,‘html.parser‘)
    news = {}
    news[‘路径‘] = url
    news[‘标题‘] = soupd.select(‘.show-title‘)[0].text
    info = soupd.select(‘.show-info‘)[0].text
    #news[‘dt‘] = datetime.strptime(info.lstrip(‘发布时间:‘)[0:19],‘%Y-%m-%d %H:%M‘)
    #news[‘source‘] = re.search(‘来源:(.*)点击‘,info).group(1).strip()
    news[‘内容‘] = soupd.select(‘.show-content‘)[0].text.strip()
    news[‘点击数‘]=getclick(url)
    return(news)

def onepage(pageurl):
    res = requests.get(pageurl)
    res.encoding = ‘utf-8‘
    soup = BeautifulSoup(res.text,‘html.parser‘)
    newsls = []
    for news in soup.select(‘li‘):
        if len(news.select(‘.news-list-title‘))>0:
            newsls.append(getdetail(news.select(‘a‘)[0][‘href‘]))
    return(newsls)
newstotal = []
gzccurl = ‘http://news.gzcc.cn/html/xiaoyuanxinwen/‘
newstotal.extend(onepage(gzccurl))

res = requests.get(gzccurl)
res.encoding=‘utf-8‘
soup = BeautifulSoup(res.text,‘html.parser‘)
n = int(soup.select(‘.a1‘)[0].text.rstrip(‘条‘))
pages=n//10+1
for i in range(2,3):
    listurl=‘http://news.gzcc.cn/html/xiaoyuanxinwen/{}.html‘.format(i)
    newstotal.extend(onepage(listurl))

df = pandas.DataFrame(newstotal)
df.to_excel(‘gzccnews.xlsx‘)
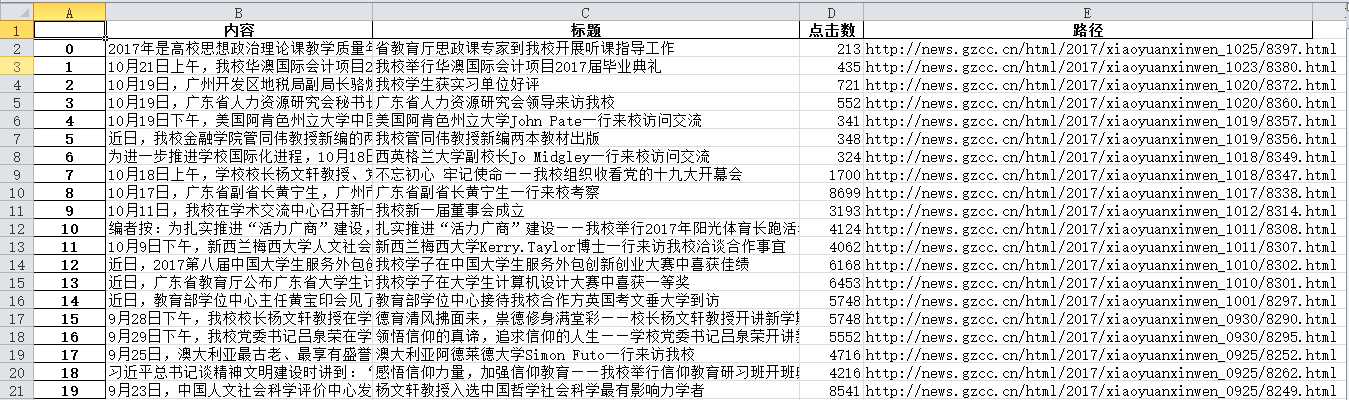
四、从DataFrame保存到sqlite3数据库
import requests
from bs4 import BeautifulSoup
from datetime import datetime
import re
import pandas
import sqlite3
def getclick(url):
    m = re.search(r‘_(.*).html‘,url)
    newsid = m.group(1)[5:]
    clickurl = ‘http://oa.gzcc.cn/api.php?op=count&id={}&modelid=80‘.format(newsid)
    resc = requests.get(clickurl).text
    r = re.search(r"hits(.*)",resc).group(1)
    click = r.lstrip("‘).html(‘").rstrip("‘);")
    return(int(click))

def getdetail(url):
    resd = requests.get(url)
    resd.encoding=‘ute-8‘
    soupd = BeautifulSoup(resd.text,‘html.parser‘)
    news = {}
    news[‘路径‘] = url
    news[‘标题‘] = soupd.select(‘.show-title‘)[0].text
    info = soupd.select(‘.show-info‘)[0].text
    #news[‘dt‘] = datetime.strptime(info.lstrip(‘发布时间:‘)[0:19],‘%Y-%m-%d %H:%M‘)
    #news[‘source‘] = re.search(‘来源:(.*)点击‘,info).group(1).strip()
    news[‘内容‘] = soupd.select(‘.show-content‘)[0].text.strip()
    news[‘点击数‘]=getclick(url)
    return(news)

def onepage(pageurl):
    res = requests.get(pageurl)
    res.encoding = ‘utf-8‘
    soup = BeautifulSoup(res.text,‘html.parser‘)
    newsls = []
    for news in soup.select(‘li‘):
        if len(news.select(‘.news-list-title‘))>0:
            newsls.append(getdetail(news.select(‘a‘)[0][‘href‘]))
    return(newsls)
newstotal = []
gzccurl = ‘http://news.gzcc.cn/html/xiaoyuanxinwen/‘
newstotal.extend(onepage(gzccurl))

res = requests.get(gzccurl)
res.encoding=‘utf-8‘
soup = BeautifulSoup(res.text,‘html.parser‘)
n = int(soup.select(‘.a1‘)[0].text.rstrip(‘条‘))
pages=n//10+1
for i in range(2,3):
    listurl=‘http://news.gzcc.cn/html/xiaoyuanxinwen/{}.html‘.format(i)
    newstotal.extend(onepage(listurl))

df = pandas.DataFrame(newstotal)
with sqlite3.connect(‘gzccnews.sqlite‘) as db:
    df.to_sql(‘gzccnews‘,con=db)

标签:bre panda ima end cli 结构化 getc one code
原文地址:http://www.cnblogs.com/zjq-013/p/7690672.html
