1. 用requests库和BeautifulSoup库,爬取校园新闻首页新闻的标题、链接、正文。
2. 分析字符串,获取每篇新闻的发布时间,作者,来源,摄影等信息。
3. 将其中的发布时间由str转换成datetime类型。
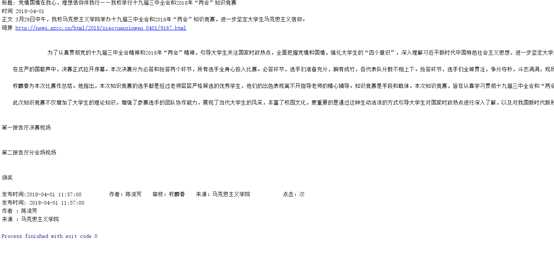
4. 将完整的代码及运行结果截图发布在作业上。
import requests
from bs4 import BeautifulSoup
from datetime import datetime
url=‘http://news.gzcc.cn/html/xiaoyuanxinwen/‘
res = requests.get(url)
res.encoding=‘utf-8‘
soup=BeautifulSoup(res.text,‘html.parser‘)
for news in soup.select(‘li‘):
    if len(news.select(‘.news-list-title‘))>0:
        t = news.select(‘.news-list-title‘)[0].text
        d = news.select(‘.news-list-info‘)[0].contents[0].text
        s = news.select(‘.news-list-description‘)[0].text
        a = news.select(‘a‘)[0].attrs[‘href‘]
        print(‘标题:‘,t)
        print(‘时间‘,d)
        print(‘正文‘,s)
        print(‘链接‘,a)

        Sres=requests.get(a)
        Sres.encoding=‘utf-8‘
        Ssoup=BeautifulSoup(Sres.text,‘html.parser‘)

        c = Ssoup.select("#content")[0].text
        print(c)
        info = Ssoup.select(".show-info")[0].text
        print(info)
        dt = info.lstrip(‘发布时间:‘)[:19]
        dati = datetime.strptime(dt,‘%Y-%m-%d %H:%M:%S‘)
        wr = info[info.find(‘作者:‘):].split()[0].lstrip(‘作者:‘)
        fr = info[info.find(‘来源:‘):].split()[0].lstrip(‘来源:‘)
        print(‘发布时间:‘,dati)
        print(‘作者‘,wr)
        print(‘来源‘,fr)
        break