
标签:shel 字符串 基础上 数据保存 返回 ted format unicode python2
字符串是Python中最常用的数据类型之一,使用单引号或双引号来创建字符串,使用三引号创建多行字符串。字符串要么使用两个双引号,要么两个单引号,不能一单一双。Python不支持单字符类型,单字符在Python也是作为一个字符串使用的。
字符串是不可变的序列数据类型,不能直接修改字符串本身,和数字类型一样。Python全面支持Unicode编码,所有的字符串都是Unicode字符串,所以传统Python2的编码问题不在困扰了,可以使用中文。
>>> var1 = ‘Hello World!‘
>>> var2 = "Jack"
>>> var3 = ""                   # 空字符串
>>> var4 = "it‘s apple"         # 双引号中可以嵌套单引号
>>> var5 = ‘This is "PLANE"!‘   # 单引号中可以嵌套双引号
>>> var6 = ‘what is ‘your‘name‘
SyntaxError: invalid syntax
但是单引号嵌套单引号或者双引号嵌套双引号报异常。
>>> a = "haha"
>>> b = a
>>> a = "xixi"
>>> a is b
False
>>> a[1] = "z"
Traceback (most recent call last):
  File "<pyshell#70>", line 1, in <module>
    a[1] = "z"
TypeError: ‘str‘ object does not support item assignment
虽然字符串本身不可变,单可以向列表一样,通过方括号叫下标的方式,访问或者获取他的子串,也包含切片操作,这一切都不会修改字符串本身,也符合字符串不可变的原则。
>>> s = "hello world!"
>>> s[4]
‘o‘
>>> s[2:6]
‘llo ‘
>>> s
‘hello world!‘
创建字符串很简单,只要为变量分配一个值即可。
var1 = "Hello world"
var2 = "Runoob"

# 结果为:
# Hello world
# Runoob
Python不支持单字符类型,单字符在Python中也是一个字符串使用。
Python访问字符串,可以使用方括号来截取字符串。
var1 = ‘Hello World!‘
var2 = "Runoob"

print ("var1[0]: ", var1[0])
print ("var2[1:5]: ", var2[1:5])

# 结果为
# var1[0]:  H
# var2[1:5]:  unoo
可以截取字符串的一部分并与他字段拼接。
var1 = "hello world"
print("更新字符串:", var1[:6] + "Runood")

# 结果为
# 更新字符串: hello Runood
需要在字符串中使用特殊字符时,Python用反斜杠(\)转义。
| 转义字符 | 描述 |
|---|---|
| \(在行尾时) | 续行符 |
| \\ | 反斜杠符号 |
| \‘ | 单引号 |
| \" | 双引号 |
| \a | 响铃 |
| \b | 退格(Backspace) |
| \e | 转义 |
| \000 | 空 |
| \n | 换行 |
| \v | 纵向制表符 |
| \t | 横向制表符 |
| \r | 回车 |
| \f | 换页 |
| \oyy | 八进制数,yy代表的字符,例如:\o12代表换行 |
| \xyy | 十六进制数,yy代表的字符,例如:\x0a代表换行 |
| \other | 其它的字符以普通格式输出 |
下标实例变量a值为字符串"Hello",b变量值为"Python"。
| 操作符 | 描述 | 实例 |
|---|---|---|
| + | 字符串连接 | a + b 输出结果: HelloPython |
| * | 重复输出字符串 | a*2 输出结果:HelloHello |
| [] | 通过索引获取字符串中字符 | a[1] 输出结果 e |
| [ : ] | 截取字符串中的一部分,遵循左闭右开原则,str[0,2] 是不包含第 3 个字符的。 | a[1:4] 输出结果 ell |
| in | 成员运算符 - 如果字符串中包含给定的字符返回 True | ‘H‘ in a 输出结果 True |
| not in | 成员运算符 - 如果字符串中不包含给定的字符返回 True | ‘M‘ not in a 输出结果 True |
| r/R | 原始字符串 - 原始字符串:所有的字符串都是直接按照字面的意思来使用,没有转义特殊或不能打印的字符。 原始字符串除在字符串的第一个引号前加上字母 r(可以大小写)以外,与普通字符串有着几乎完全相同的语法。 |
print( r‘\n‘ )
print( R‘\n‘ )
|
| % | 格式字符串 | 请看下一节内容。 |
a = "Hello"
b = "Python"

print("a + b 输出结果:", a + b)
print("a * 2 输出结果:", a * 2)
print("a[1] 输出结果:", a[1])
print("a[1:4] 输出结果:", a[1:4])

if( "H" in a) :
    print("H 在变量 a 中")
else :
    print("H 不在变量 a 中")

if( "M" not in a) :
    print("M 不在变量 a 中")
else :
    print("M 在变量 a 中")

print (r‘\n‘)
print (R‘\n‘)

# 结果为
# a + b 输出结果: HelloPython
# a * 2 输出结果: HelloHello
# a[1] 输出结果: e
# a[1:4] 输出结果: ell
# H 在变量 a 中
# M 不在变量 a 中
# \n
# \n
在字符串中,可以使用三引号(三单或三双引号都可以)编写跨行字符串,在其中可以包含换行符,制表符以及其他特殊字符。
errHTML = ‘‘‘
<HTML><HEAD><TITLE>
Friends CGI Demo</TITLE></HEAD>
<BODY><H3>ERROR</H3>
<B>%s</B><P>
<FORM><INPUT TYPE=button VALUE=Back
ONCLICK="window.history.back()"></FORM>
</BODY></HTML>
‘‘‘
----------------------------------
cursor.execute(‘‘‘
CREATE TABLE users (
login VARCHAR(8),
uid INTEGER,
prid INTEGER)
‘‘‘)
上面的errHTML是一个封装了HTML代码的字符串,而cursor.execute则执行了一个创建users表的SQL语句。多行字符串本质上和普通字符串没有区别,但是将我们从引号和特殊字符串的泥潭里面解脱出来了,在编写、排版、查看、维护上更人性化。
在Python2中,普通字符串是8位ASCII码进行储存的,而Unicode字符串则储存为16为unicode字符串,这样能够表示更多的字符集,使用的语法就是在字符前面加上前缀u.
1.capitalize():将字符串的第一个字符转换为大写。
2.casefold():转换字符串中所有大写字符为小写,比 lower() 方法更牛,支持更多语言。
3.center():返回一个指定的宽度 width 居中的字符串,fillchar 为填充的字符,默认为空格。
4.count():返回 str 在 string 里面出现的次数,如果 beg 或者 end 指定则返回指定范围内 str 出现的次数。
5.encode():以 encoding 指定的编码格式编码字符串,如果出错默认报一个ValueError 的异常,除非 errors 指定的是‘ignore‘或者‘replace‘。
6.endswith():检查字符串是否以 obj 结束,如果beg 或者 end 指定则检查指定的范围内是否以 obj 结束,如果是,返回 True,否则返回 False。
7.expandtabs():把字符串 string 中的 tab 符号转为空格,tab 符号默认的空格数是 8 。
8.find():检测 str 是否包含在字符串中,如果指定范围 beg 和 end ,则检查是否包含在指定范围内,如果包含返回开始的索引值,否则返回-1。
9.format():字符串格式化。
10.format_map():类似 str.format(*args, **kwargs) ,不同的是 mapping 是一个字典对象。
11index():跟find()方法一样,只不过如果str不在字符串中会报一个异常。
12.isalnum():如果字符串至少有一个字符并且所有字符都是字母或数字则返 回 True,否则返回 False。
13.isalpha():如果字符串至少有一个字符并且所有字符都是字母则返回 True, 否则返回 False。
14.isdecimal():检查字符串是否只包含十进制字符,如果是返回 True,否则返回 False。
15.isdigit():如果字符串只包含数字则返回 True 否则返回 False..。
16.isidentifier():判断字符串是否是有效的 Python 标识符,如果是返回 True,否则返回 False。
17.islower():如果字符串中包含至少一个区分大小写的字符,并且所有这些(区分大小写的)字符都是小写,则返回 True,否则返回 False。
18.isnumeric():如果字符串中只包含数字字符,则返回 True,否则返回 False。
19.isprintable():判断字符串中所有字符是否都是可打印字符或字符串为空,如果是返回 True,否则返回 False
20.isspace():如果字符串中只包含空白,则返回 True,否则返回 False。
21.istitle():如果字符串是标题化的(见 title())则返回 True,否则返回 False。
22.isupper():如果字符串中包含至少一个区分大小写的字符,并且所有这些(区分大小写的)字符都是大写,则返回 True,否则返回 False。
23.join():以指定字符串作为分隔符,将 seq 中所有的元素(的字符串表示)合并为一个新的字符串。
24.ljust():返回一个原字符串左对齐,并使用 fillchar 填充至长度 width 的新字符串,fillchar 默认为空格。
25.lower():转换字符串中所有大写字符为小写。
26.lstrip():截掉字符串左边的空格或指定字符。
27.partition():根据指定的分隔符将字符串进行分割,返回一个3元的元祖,第一个为分隔符前面的子字符串,第二个为分隔符本身,第三个为分隔符后面的子字符串。
28.replace():把 将字符串中的 str1 替换成 str2,如果 max 指定,则替换不超过 max 次。
29.rfind():类似于 find()函数,不过是从右边开始查找。
30.rindex():类似于 index(),不过是从右边开始。
31.rjust():返回一个原字符串右对齐,并使用fillchar(默认空格)填充至长度 width 的新字符串。
32.rpartition():类似于 partition()方法,只不过是从字符串最后面开始分割。
33.rsplit():类似于 split() 方法 ,只不过是从字符串最后面开始分割。
34.rstrip():删除字符串字符串末尾的空格。
35.split():指定分隔符对字符串进行分割并返回一个列表,默认分隔符为所有空字符,包括空格、换行(\n)、制表符(\t)等。
36.splitlines():按照行界符(‘\r‘, ‘\r\n‘, \n‘等)分隔,返回一个包含各行作为元素的列表,默认不包含行界符
37.startswith():用于判断字符串是否以指定前缀开头,如果是则返回 True,否则返回 False
38.strip():删除字符串头部和尾部指定的字符,默认字符为所有空字符,包括空格、换行(\n)、制表符(\t)等。
39.swapcase():将字符串中大写转换为小写,小写转换为大写。
40.title():返回"标题化"的字符串,就是说所有单词都是以大写开始,其余字母均为小写。
41.translate():根据 maketrans() 方法给出的字符映射转换表转换字符串中的字符。
42.upper():转换字符串中的小写字母为大写。
43.zfill():返回指定长度的字符串,原字符串右对齐,前面填充0。
44.max():返回字符串 str 中最大的字母。
45.min():返回字符串 str 中最小的字母。
46.maketrans():创建字符映射的转换表,对于接受两个参数的最简单的调用方式,第一个参数是字符串,表示需要转换的字符,第二个参数也是字符串表示转换的目标。
47.bytes.decode():Python3 中没有 decode 方法,但我们可以使用 bytes 对象的 decode() 方法来解码给定的 bytes 对象,这个 bytes 对象可以由 str.encode() 来编码返回。
48.len():返回字符串长度。
49.str():将对象转化为适于人阅读的形式(字符串形式)。
Python内置字符串方法(收藏专用):https://segmentfault.com/a/1190000004598007
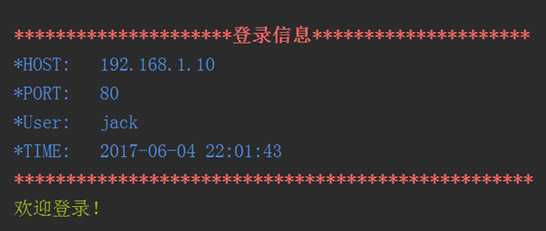
有时候我们需要对有用的信息设置不同颜色来达到强调、突出、美观的效果,在命令行或linux终端中,颜色是用转义序列控制的,转义序列是以ESC开头,在代码中用\033表示(ESC的ASCII码用十进制表示就是27,等于用八进制表示的33,\0表示八进制)。注意:颜色控制只在终端界面中有效。
格式:
\033[显示方式;前景色;背景色m正文\033[0m
| 前景色 | 背景色 | 颜色 |
|---|---|---|
| 30 | 40 | 黑色 |
| 31 | 41 | 红色 |
| 32 | 42 | 绿色 |
| 33 | 43 | 黃色 |
| 34 | 44 | 蓝色 |
| 35 | 45 | 紫红色 |
| 36 | 46 | 青蓝色 |
| 37 | 47 | 白色 |
显示方式:
| 显示方式 | 意义 |
|---|---|
| 0 | 终端默认设置 |
| 1 | 高亮显示 |
| 4 | 使用下划线 |
| 5 | 闪烁 |
| 7 | 反白显示 |
| 8 | 不可见 |
例子:
\033[1;31;40m 1-高亮显示 31-前景色红色 40-背景色黑色
\033[0m 采用终端默认设置,也就是取消颜色设置
import time

print(‘\033[1;31m‘)
print(‘登录信息‘.center(46, "*"), "\033[0m")
print(‘\033[34m*HOST:\t‘, "192.168.1.10")
print(‘*PORT:\t‘, "80")
print(‘*User:\t‘, "jack")
print(‘*TIME:\t‘, time.strftime("%Y-%m-%d %H:%M:%S", time.localtime()))
print(‘\033[1;31m*‘ * 50, ‘\033[0m‘)
print("\033[32m欢迎登录!\033[0m")
计算机只能处理数字01,如果要处理文本,就必须先把文本转换为数字01,这种转换方式就称为字符编码。
对于我们而言,你只需要简单记住下面几种编码就好:
ASCII编码:早期专门为英语语系编码,只有255个字符,每个字符需要8位也就是1个字节。不兼容汉字。
Unicode编码:又称万国码,国际组织制定的可以容纳世界上所有文字和符号的字符编码方案。用2个字节来表示汉字。
UTF-8编码:为了节省字节数,在Unicode的基础上进行优化的编码。用1个字节表示英文字符,3个字符表示汉字。天生兼容ASCII编码,所以最为流行。
GB2312:我国早期自己制定的中文编码,世界范围内不通用。
GBK: 全称《汉字内码扩展规范》,向下与GB2312兼容,向上支持ISO10646.1国际标准,是前者向后者过渡过程中的一个承上启下的产物。windows中文版的汉字编码用的就是GBK。也非世界范围通用的编码
其它编码:非以上类型者的统称。属于能不用就不要碰的编码。
最后再强调一次,Python3在运行时全部使用Unicode编码!
另外有这么几条规则,你要记住:
操作系统运行时,在内存中,统一使用的都是Unicode编码,当需要将数据保存到硬盘或者网络传输的时候,就转换为UTF-8编码,进行保存和传输。
用文本编辑器的时候,从文件系统或者说硬盘上读取的UTF-8编码字符被转换为Unicode字符到内存里,供程序或者操作系统使用。编辑完成后,保存的时候再把Unicode转换为UTF-8保存到文件。
浏览网页的时候,服务器会把动态生成的Unicode内容转换为UTF-8传输到客户的浏览器。
这就是为什么我们一会说Unicode,一会又用utf-8的原因。
另外,一定要区分代码自己本身的编码和程序要处理的数据的编码!没有特殊要求的情况,请使用utf-8编码。确保文本编辑器使用的是UTF-8 without BOM编码。
标签:shel 字符串 基础上 数据保存 返回 ted format unicode python2
原文地址:https://www.cnblogs.com/xiaohei001/p/10119273.html
