
标签:数值 线索二叉树 mat 数据 代码 int tostring img 下标
1、二叉树
1.1 为什么需要树这种数据结构
1)数组存储方式的分析
优点:通过下标方式访问元素,速度快。对于有序数组,还可以使用二分查找检索速度。
缺点:如果要检索具体某个值,或者插入值(按一定顺序)回整体移动,效率较低
2)链式存储方式的分析
优点:在一定程度上对数组存储方式有优化(插入一个数值节点,只需要将插入节点,链接到链表中即可,删除效率也很好)
缺点:在进行检索时,效率仍然较低,比如(检索某个值,需要从节点开始遍历)
3)树存储方式的分析
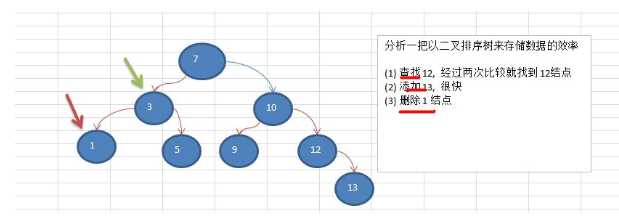
能提高数据存储,读取的效率,比如利用二叉排序树,既可以保证数据的检索速度,同时也可以保证数据的插入,删除,修改的速度。
案例:[7,3,10,1,5,9,12]
1.2 二叉树的概念
1)树有很多种,每个节点最多只能有两个子节点的一种形式称为二叉树。
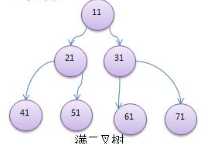
2)如果该二叉树的所有叶子节点都在最后一层,并且结点总数=2^n-1,n为层数,则我们称为满二叉树。
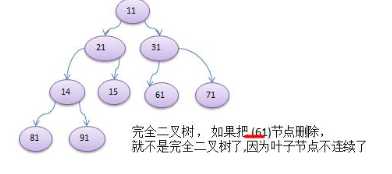
3)如果该二叉树的所有叶子节点都在最后一层或者倒数第二层,而且最后一层的叶子节点在左边连续,倒数第二层的叶子节点在右边连续,我们称为完全二叉树
结点HeroNode, 定义二叉树BinaryTree,创建二叉树binaryTree
public class BinaryTreeDemo {
public static void main(String[] args) {
        //先需要创建一颗二叉树
        BinaryTree binaryTree = new BinaryTree();
        //创建需要的结点
        HeroNode root = new HeroNode(1, "宋江");
        HeroNode node2 = new HeroNode(2, "吴用");
        HeroNode node3 = new HeroNode(3, "卢俊义");
        HeroNode node4 = new HeroNode(4, "林冲");
        HeroNode node5 = new HeroNode(5, "关胜");

        //说明,我们先手动创建该二叉树,后面我们学习递归的方式创建二叉树
        root.setLeft(node2);
        root.setRight(node3);
        node3.setRight(node4);
        node3.setLeft(node5);
        binaryTree.setRoot(root);
}
}
//定义BinaryTree 二叉树
class BinaryTree {
    private HeroNode root;

    public void setRoot(HeroNode root) {
        this.root = root;
    }
}
//先创建HeroNode 结点
class HeroNode {
    private int no;
    private String name;
    private HeroNode left; //默认null
    private HeroNode right; //默认null
    public HeroNode(int no, String name) {
        this.no = no;
        this.name = name;
    }
    public int getNo() {
        return no;
    }
    public void setNo(int no) {
        this.no = no;
    }
    public String getName() {
        return name;
    }
    public void setName(String name) {
        this.name = name;
    }
    public HeroNode getLeft() {
        return left;
    }
    public void setLeft(HeroNode left) {
        this.left = left;
    }
    public HeroNode getRight() {
        return right;
    }
    public void setRight(HeroNode right) {
        this.right = right;
    }
    @Override
    public String toString() {
        return "HeroNode [no=" + no + ", name=" + name + "]";
    }
}
1.3 二叉树遍历
使用前序,中序和后序对下面的二叉树进行遍历
1)前序遍历:先输出父节点,再遍历左子树和右子树
2)中序遍历:先遍历左子树,再输出父节点,再遍历右子树
3)后序遍历:先遍历左子树,再遍历右子树,最后输出父节点
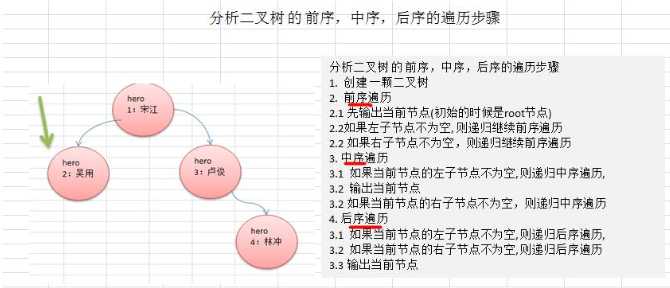
基于1.2的代码, 以前序遍历为例:中序遍历infixOrder与后序遍历postOrder只需要将前序遍历的System.out.println(this);分别放在左子树遍历后与右子树遍历后
class BinaryTree {
    //前序遍历
    public void preOrder() {
        if(this.root != null) {
            this.root.preOrder();
        }else {
            System.out.println("二叉树为空,无法遍历");
        }
    }
}
class HeroNode {
        //编写前序遍历的方法
    public void preOrder() {
        System.out.println(this); //先输出父结点
        //递归向左子树前序遍历
        if(this.left != null) {
            this.left.preOrder();
        }
        //递归向右子树前序遍历
        if(this.right != null) {
            this.right.preOrder();
        }
    }
}
1.4 查找指定节点
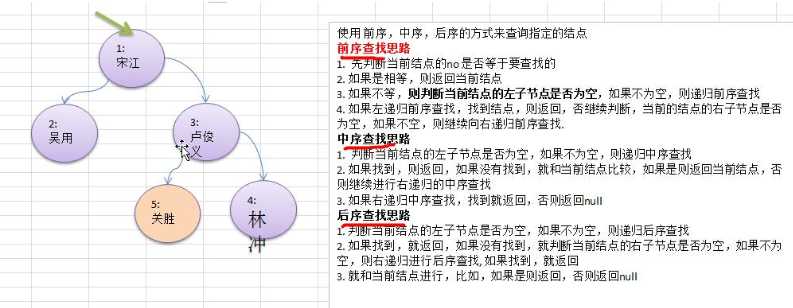
基于1.2的代码,以前序遍历为例,中序遍历,后续遍历类似
class BinaryTree {
        public HeroNode preOrderSearch(int no) {
        if(root != null) {
            return root.preOrderSearch(no);
        } else {
            return null;
        }
    }
}
class HeroNode {
//前序遍历查找
    public HeroNode preOrderSearch(int no) {
        System.out.println("进入前序遍历");
        //比较当前结点是不是
        if(this.no == no) {
            return this;
        }
        //1.则判断当前结点的左子节点是否为空,如果不为空,则递归前序查找
        //2.如果左递归前序查找,找到结点,则返回
        HeroNode resNode = null;
        if(this.left != null) {
            resNode = this.left.preOrderSearch(no);
        }
        if(resNode != null) {//说明我们左子树找到
            return resNode;
        }
        //1.左递归前序查找,找到结点,则返回,否继续判断,
        //2.当前的结点的右子节点是否为空,如果不空,则继续向右递归前序查找
        if(this.right != null) {
            resNode = this.right.preOrderSearch(no);
        }
        return resNode;
    }
}
2、顺序存储二叉树
从数据存储来看,数组存储方式和树的存储方式可以相互转换,即数组可以转换成树,树也可以转换成数组。
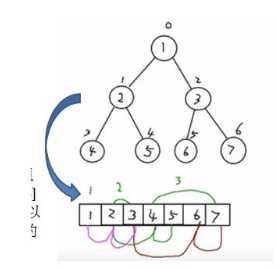
要求:
1)右图的二叉树的结点,要求以数组的方式来存放arr:[1,2,3,4,5,6,6]
2)要求在遍历数组arr时,仍然可以以前序遍历,中序遍历和后序遍历的方式完成结点的遍历
顺序存储二叉树的特点:
1)顺序二叉树通常只考虑完全二叉树
2)第n个元素的左子节点为2*n+1
3)第n个元素的右子节点为2*n+2
4)第n个元素的父节点为(n-1)/2
5)n:表示二叉树中的第几个元素(按0开始编号如图所示)
前序遍历为例,这里的代码和之前的没有关系了。
public class ArrBinaryTreeDemo {
    public static void main(String[] args) {
        int[] arr = { 1, 2, 3, 4, 5, 6, 7 };
        //创建一个 ArrBinaryTree
        ArrBinaryTree arrBinaryTree = new ArrBinaryTree(arr);
        arrBinaryTree.preOrder(); // 1,2,4,5,3,6,7
    }
}

//编写一个ArrayBinaryTree, 实现顺序存储二叉树遍历
class ArrBinaryTree {
    private int[] arr;//存储数据结点的数组

    public ArrBinaryTree(int[] arr) {
        this.arr = arr;
    }
    //重载preOrder
    public void preOrder() {
        this.preOrder(0);
    }

    //编写一个方法,完成顺序存储二叉树的前序遍历
    /**
     *
     * @param index 数组的下标
     */
    public void preOrder(int index) {
        //如果数组为空,或者 arr.length = 0
        if(arr == null || arr.length == 0) {
            System.out.println("数组为空,不能按照二叉树的前序遍历");
        }
        //输出当前这个元素
        System.out.println(arr[index]);
        //向左递归遍历
        if((index * 2 + 1) < arr.length) {
            preOrder(2 * index + 1 );
        }
        //向右递归遍历
        if((index * 2 + 2) < arr.length) {
            preOrder(2 * index + 2);
        }
    }
}
3、线索化二叉树
3.1 线索二叉树基本介绍
1)n个结点的二叉链表中含有n+1【公式2n-(n-1)=n+1】个空指针域。利用二叉链表中的空指针域,存放指向该结点在某种遍历次序下的前驱和后继结点的指针(这种附加的指针称为"线索")
2)这种加上了线索的二叉链表称为线索链表,相应的二叉树称为线索二叉树(ThreadedBinaryTree)。根据线索性质的不同,线索二叉树可分为前序线索二叉树、中序线索二叉树和后序线索二叉树三种
3)一个结点的前一个结点,称为前驱结点
4)一个结点的后一个结点,称为后继结点
3.2 应用实例
应用案例说明:将下面的二叉树,进行中序线索二叉树。中序遍历的数列为{8,3,10,1,14,6}
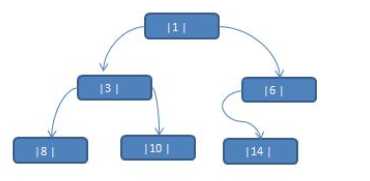
思路分析:中序遍历的结果:{8,3,10,1,14,6}
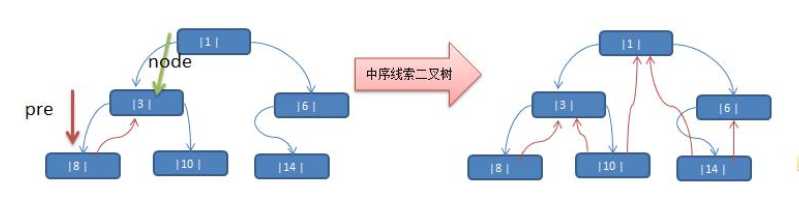
说明:当线索化二叉树后,Node节点的属性left和right,有如下情况:
1)left指向的是左子树,也可能是指向的前驱节点.比如①节点left指向的左子树,而⑩节点的left指向的就是前驱节点.
2)right指向的是右子树,也可能是指向后继节点,比如①节点right指向的是右子树,而⑩节点的right指向的是后继节点
创建结点是只需要将1.2的class HeroNode{}的代码复制过来加入以下代码并且得到它的get,set函数。main函数与之前的相似
 private int leftType;
 private int rightType;
因为线索化后,各个结点指向有变化,因此原来的遍历方式不能使用,这时需要使用新的方式遍历线索化二叉树,各个节点可以通过线型方式遍历,因此无需使用递归方式,这样也提高了遍历的效率。遍历的次序应当和中序遍历保持一致。
//定义ThreadedBinaryTree 实现了线索化功能的二叉树
class ThreadedBinaryTree {
    private HeroNode root;

    //为了实现线索化,需要创建要给指向当前结点的前驱结点的指针
    //在递归进行线索化时,pre 总是保留前一个结点
    private HeroNode pre = null;

    public void setRoot(HeroNode root) {
        this.root = root;
    }

    //重载一把threadedNodes方法
    public void threadedNodes() {
        this.threadedNodes(root);
    }

    //遍历线索化二叉树的方法
    public void threadedList() {
        //定义一个变量,存储当前遍历的结点,从root开始
        HeroNode node = root;
        while(node != null) {
            //循环的找到leftType == 1的结点,第一个找到就是8结点
            //后面随着遍历而变化,因为当leftType==1时,说明该结点是按照线索化
            //处理后的有效结点
            while(node.getLeftType() == 0) {
                node = node.getLeft();
            }

            //打印当前这个结点
            System.out.println(node);
            //如果当前结点的右指针指向的是后继结点,就一直输出
            while(node.getRightType() == 1) {
                //获取到当前结点的后继结点
                node = node.getRight();
                System.out.println(node);
            }
            //替换这个遍历的结点
            node = node.getRight();

        }
    }

    //编写对二叉树进行中序线索化的方法
    /**
     *
     * @param node 就是当前需要线索化的结点
     */
    public void threadedNodes(HeroNode node) {

        //如果node==null, 不能线索化
        if(node == null) {
            return;
        }

        //(一)先线索化左子树
        threadedNodes(node.getLeft());
        //(二)线索化当前结点[有难度]

        //处理当前结点的前驱结点
        //以8结点来理解
        //8结点的.left = null , 8结点的.leftType = 1
        if(node.getLeft() == null) {
            //让当前结点的左指针指向前驱结点
            node.setLeft(pre);
            //修改当前结点的左指针的类型,指向前驱结点
            node.setLeftType(1);
        }

        //处理后继结点
        if (pre != null && pre.getRight() == null) {
            //让前驱结点的右指针指向当前结点
            pre.setRight(node);
            //修改前驱结点的右指针类型
            pre.setRightType(1);
        }
        //!!! 每处理一个结点后,让当前结点是下一个结点的前驱结点
        pre = node;

        //(三)在线索化右子树
        threadedNodes(node.getRight());
    }
4、二叉排序树
二叉排序树:BST:(BinarySort(Search)Tree),对于二叉排序树的任何一个非叶子节点,要求左子节点的值比当前节点的值小,右子节点的值比当前节点的值大。
特别说明:如果有相同的值,可以将该节点放在左子节点或右子节点
4.1 创建
//创建Node结点
class Node {
    int value;
    Node left;
    Node right;
    public Node(int value) {

        this.value = value;
    }
            //添加结点的方法
    //递归的形式添加结点,注意需要满足二叉排序树的要求
    public void add(Node node) {
        if(node == null) {
            return;
        }

        //判断传入的结点的值,和当前子树的根结点的值关系
        if(node.value < this.value) {
            //如果当前结点左子结点为null
            if(this.left == null) {
                this.left = node;
            } else {
                //递归的向左子树添加
                this.left.add(node);
            }
        } else { //添加的结点的值大于 当前结点的值
            if(this.right == null) {
                this.right = node;
            } else {
                //递归的向右子树添加
                this.right.add(node);
            }

        }
    }
}
//创建二叉排序树
class BinarySortTree {
    private Node root;
    public Node getRoot() {
        return root;
    }
    //添加结点的方法
    public void add(Node node) {
        if(root == null) {
            root = node;//如果root为空则直接让root指向node
        } else {
            root.add(node);
        }
    }
}
public static void main(String[] args) {
        int[] arr = {7, 3, 10, 12, 5, 1, 9, 2};
        BinarySortTree binarySortTree = new BinarySortTree();
        //循环的添加结点到二叉排序树
        for(int i = 0; i< arr.length; i++) {
            binarySortTree.add(new Node(arr[i]));
        }
}
4.2 删除结点
二叉排序树的删除情况比较复杂,有下面三种情况需要考虑
1)删除叶子节点(比如:2,5,9,12)
2)删除只有一颗子树的节点(比如:1)
3)删除有两颗子树的节点.(比如:7,3,10)
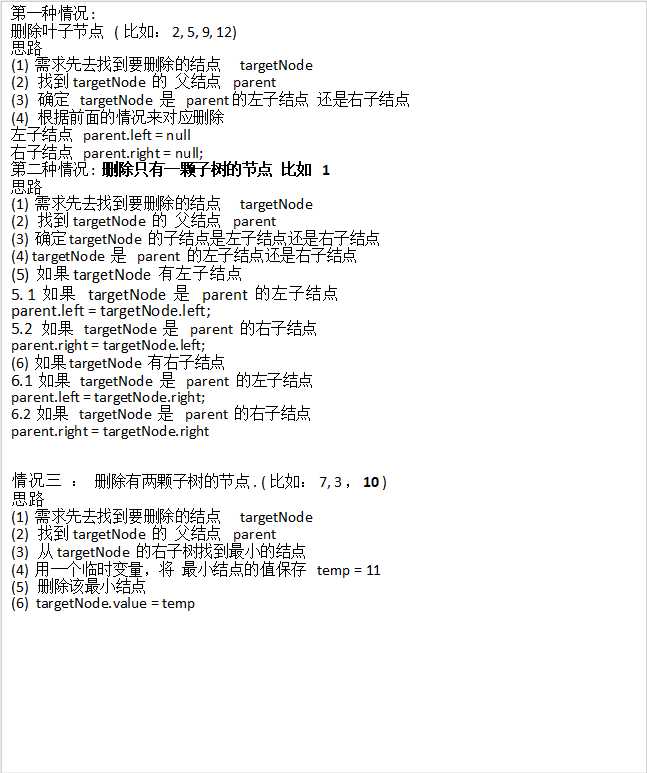
基于4.1代码,寻找要删除的结点,要删除结点的父结点
class Node {
    int value;
    Node left;
    Node right;
    public Node(int value) {
        this.value = value;
    }

    //查找要删除的结点
    /**
     *
     * @param value 希望删除的结点的值
     * @return 如果找到返回该结点,否则返回null
     */
    public Node search(int value) {
        if(value == this.value) { //找到就是该结点
            return this;
        } else if(value < this.value) {//如果查找的值小于当前结点,向左子树递归查找
            //如果左子结点为空
            if(this.left  == null) {
                return null;
            }
            return this.left.search(value);
        } else { //如果查找的值不小于当前结点,向右子树递归查找
            if(this.right == null) {
                return null;
            }
            return this.right.search(value);
        }

    }
    //查找要删除结点的父结点
    /**
     *
     * @param value 要找到的结点的值
     * @return 返回的是要删除的结点的父结点,如果没有就返回null
     */
    public Node searchParent(int value) {
        //如果当前结点就是要删除的结点的父结点,就返回
        if((this.left != null && this.left.value == value) ||
                (this.right != null && this.right.value == value)) {
            return this;
        } else {
            //如果查找的值小于当前结点的值, 并且当前结点的左子结点不为空
            if(value < this.value && this.left != null) {
                return this.left.searchParent(value); //向左子树递归查找
            } else if (value >= this.value && this.right != null) {
                return this.right.searchParent(value); //向右子树递归查找
            } else {
                return null; // 没有找到父结点
            }
        }

    }

    @Override
    public String toString() {
        return "Node [value=" + value + "]";
    }
}
基于4.1的代码,删除结点
class BinarySortTree {
    private Node root;
    public Node getRoot() {
        return root;
    }

    //查找要删除的结点
    public Node search(int value) {
        if(root == null) {
            return null;
        } else {
            return root.search(value);
        }
    }

    //查找父结点
    public Node searchParent(int value) {
        if(root == null) {
            return null;
        } else {
            return root.searchParent(value);
        }
    }

    //编写方法:
    //1. 返回的 以node 为根结点的二叉排序树的最小结点的值
    //2. 删除node 为根结点的二叉排序树的最小结点
    /**
     *
     * @param node 传入的结点(当做二叉排序树的根结点)
     * @return 返回的 以node 为根结点的二叉排序树的最小结点的值
     */
    public int delRightTreeMin(Node node) {
        Node target = node;
        //循环的查找左子节点,就会找到最小值
        while(target.left != null) {
            target = target.left;
        }
        //这时 target就指向了最小结点
        //删除最小结点
        delNode(target.value);
        return target.value;
    }


    //删除结点
    public void delNode(int value) {
        if(root == null) {
            return;
        }else {
            //1.需求先去找到要删除的结点  targetNode
            Node targetNode = search(value);
            //如果没有找到要删除的结点
            if(targetNode == null) {
                return;
            }
            //如果我们发现当前这颗二叉排序树只有一个结点
            if(root.left == null && root.right == null) {
                root = null;
                return;
            }

            //去找到targetNode的父结点
            Node parent = searchParent(value);
            //如果要删除的结点是叶子结点
            if(targetNode.left == null && targetNode.right == null) {
                //判断targetNode 是父结点的左子结点,还是右子结点
                if(parent.left != null && parent.left.value == value) { //是左子结点
                    parent.left = null;
                } else if (parent.right != null && parent.right.value == value) {//是由子结点
                    parent.right = null;
                }
            } else if (targetNode.left != null && targetNode.right != null) { //删除有两颗子树的节点
                int minVal = delRightTreeMin(targetNode.right);
                targetNode.value = minVal;


            } else { // 删除只有一颗子树的结点
                //如果要删除的结点有左子结点
                if(targetNode.left != null) {
                    if(parent != null) {
                        //如果 targetNode 是 parent 的左子结点
                        if(parent.left.value == value) {
                            parent.left = targetNode.left;
                        } else { //  targetNode 是 parent 的右子结点
                            parent.right = targetNode.left;
                        }
                    } else {
                        root = targetNode.left;
                    }
                } else { //如果要删除的结点有右子结点
                    if(parent != null) {
                        //如果 targetNode 是 parent 的左子结点
                        if(parent.left.value == value) {
                            parent.left = targetNode.right;
                        } else { //如果 targetNode 是 parent 的右子结点
                            parent.right = targetNode.right;
                        }
                    } else {
                        root = targetNode.right;
                    }
                }

            }

        }
    }
}
五、 平衡二叉树
给你一个数列{1,2,3,4,5,6},要求创建一颗二叉排序树(BST),并分析问题所在.
左边BST存在的问题分析:
1)左子树全部为空,从形式上看,更像一个单链表
2)插入速度没有影响
3)查询速度明显降低(因为需要依次比较),不能发挥BST的优势,因为每次还需要比较左子树,其查询速度比单链表还慢
4)解决方案-平衡二叉树(AVL)
5.1 基本介绍
1)平衡二叉树也叫平衡二叉搜索树(Self-balancingbinarysearchtree)又被称为AVL树,可以保证查询效率较高。
2)具有以下特点:它是一棵空树或